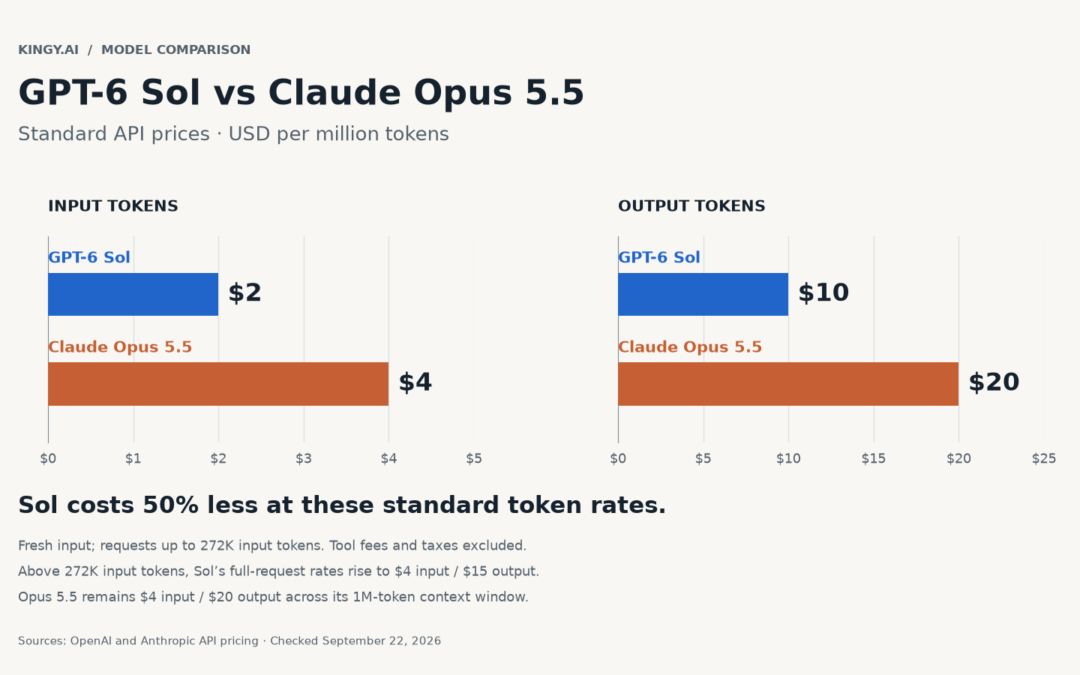
Anthropic acaba de tirar su tier premium a la basura: Opus 5.5 rinde a nivel de Fable 5.1 por menos de la mitad del precio, y no te cobra recargo cuando tu prompt pasa de 272K tokens. Mientras OpenAI te factura el request completo a precio doble pasados 272K de input, Anthropic mantiene tarifa plana en toda su ventana de 1M. Eso no es una rebaja, es un cambio de reglas.
Si tu stack vive de agentes, coding o RAG con contexto re-leído, esto te afecta más que cualquier benchmark. El Claude Opus 5.5 pricing reordena la decisión de stack por tamaño de prompt, no por leaderboard. Y la mayoría de equipos sigue eligiendo modelo mirando el SWE-bench, no su factura.
Qué pasó
El 22 de septiembre de 2026 Anthropic lanzó Claude Opus 5.5, primer modelo de la familia 5.5. Los números oficiales: $4 por millón de tokens de entrada y $20 por millón de salida, frente a los $5 y $25 de Opus 5. Eso es un 20% de rebaja en ambos extremos. Las lecturas de caché caen a $0.20/M (60% menos que los $0.50/M anteriores) y las escrituras de caché bajan de $6.25 a $5/M.
Anthropic cifra el ahorro en cargas típicas a configuración default en ~40% frente a Opus 5, combinando tarifas más bajas con menor consumo de tokens por tarea. De paso, el output sale >30% más rápido. Y el detalle estructural: cero tier de contexto largo. Misma tarifa en toda la ventana de 1M de tokens, con salida máxima de 128K.
OpenAI juega al revés. GPT-6 Sol cuesta $2/M entrada y $10/M salida en contexto corto, pero pasados 272K tokens de input factura todo el request a $4/M entrada, $0.40/M caché y $15/M salida. No es un recargo sobre el excedente: es precio doble aplicado al prompt completo.
Qué significa
Haz la cuenta en el umbral de 272K. El input de Sol iguala a Opus 5.5 ($4/M los dos). Su caché cuesta el doble ($0.40 vs $0.20). Y solo el output sigue un 25% más barato ($15 vs $20). Traducción: si tu prompt cruza ese umbral, la ventaja nominal de Sol se evapora y en cargas con caché intensiva se invierte.
Ahí está la trampa de elegir por benchmark. Sol es ~50% más barato que Opus 5.5 en contexto corto sin caché ($2/$10 vs $4/$20). Pero si tu agente re-lee un repo de 400K tokens veinte veces por tarea, el modelo barato te sale caro. El Claude Opus 5.5 precio API contexto largo no es un número, es una función del tamaño de tu prompt.
Y ojo con el claim del 40%. Stokastic señala que Anthropic nunca publicó tarifas de entrada/salida de Opus 5, así que el «40% más barato» no se puede verificar contra una lista pública. El 60% es el gap real contra Fable 5.1 ($10/$50). El 40% es una estimación de coste por tarea, no un precio de tarifa. Dato sin criterio = ruido, y aquí el criterio es distinguir tarifa de coste operativo.
El movimiento canibaliza su propio flagship. Fable 5.1, lanzado el 1 de septiembre a $10/$50, ahora rinde parecido a Opus 5.5 por 60% menos. Fable solo se justifica por su ratio de caché o por acceso a capacidades Mythos para organizaciones verificadas. Anthropic se disparó al pie y probablemente lo sabe.
Qué hacer al respecto
Cuatro movimientos, en este orden:
- Modela coste por tamaño de prompt, no por benchmark. Saca la distribución real de tokens de input de tus llamadas (p50, p90, p99). Si tu p90 pasa de 272K, el recargo de OpenAI puede anular la ventaja de Sol. Si tu p90 está bajo 100K, Sol sigue ganando por goleada.
- Prioriza tarifa de caché en agentes y coding. Opus 5.5 a $0.20/M es la mitad que Sol en contexto largo ($0.40/M) y un quinto que Astra ($1.00/M). Si re-lees contexto, la caché pesa más que el input base. Calcula el ratio caché/total de tus requests antes de decidir.
- Reevalúa Fable 5.1 hoy. Con Opus 5.5 rindiendo a su nivel por 60% menos, mantener Fable por inercia es quemar margen. Migra lo que no necesite Mythos y mide la diferencia en tu harness.
- Usa modo Fast ($8/$40) solo si la latencia es crítica. Para el resto, estándar y batch ($2/$10) maximizan el ahorro. El 2.5x de velocidad se paga caro y casi nunca es el cuello de botella real de tu producto.
Y una advertencia de Kingy AI que vale oro: en cargas con caché muy intensiva el cálculo se invierte, y no existe aún comparación pública en el mismo harness entre GPT-6 Sol y Opus 5.5 en los benchmarks agénticos principales. Tu propio harness es el único benchmark que importa.
Si estás eligiendo modelo esta semana, deja de mirar el leaderboard y abre tu factura. ¿Cuál es tu p90 de tokens de input? Ese número decide tu stack, no el marketing de ninguno de los dos labs. Cuéntame en comentarios qué te sale la cuenta.
Preguntas frecuentes
¿Cuánto cuesta Claude Opus 5.5 por millón de tokens?
Entrada a $4/M y salida a $20/M, con lecturas de caché a $0.20/M y escrituras a $5/M. El modo Fast sube a $8/$40 y batch baja a $2/$10.
¿OpenAI cobra más por contexto largo en GPT-6 Sol?
Sí. Pasados 272K tokens de input, factura todo el request a $4/M entrada, $0.40/M caché y $15/M salida. No es un recargo sobre el excedente, es precio doble aplicado al prompt completo.
¿Es verdad que Opus 5.5 es 40% más barato que Opus 5?
El 40% es una estimación de coste operativo por tarea en cargas típicas, no un precio de tarifa verificable. La rebaja de tarifa pública es del 20% en entrada y salida. El 60% real es contra Fable 5.1 ($10/$50).
¿Cuándo conviene GPT-6 Sol sobre Opus 5.5?
Cuando tu input se mantiene bajo 272K tokens y no dependes de caché intensiva. Ahí Sol es ~50% más barato. Si cruzas el umbral o re-lees contexto masivamente, Opus 5.5 gana.