OpenAI metió GPT-Live-1 en la API a $0.05 por minuto y si tu call center sigue con IVR de menús, ya estás pagando por llamadas que no cierras.
El 10 de septiembre de 2026 OpenAI abrió a desarrolladores el mismo modelo de voz full-duplex que venía operando dentro de ChatGPT Voice desde julio. No es un wrapper nuevo sobre el Realtime API de 2024: es el reemplazo. Escucha y habla al mismo tiempo, aguanta interrupciones y delega el razonamiento pesado a modelos backend como GPT-6 Astra o Codex.
Mi postura, sin rodeos: esto no es una feature más. Es una reingeniería del costo por llamada. Y como toda jugada de OpenAI, el precio de portada esconde la letra chica. Si te lo tomas literal, te va a salir caro.
Qué pasó
GPT-Live-1 cuesta $0.05 por minuto por la capa de voz front-end. El modelo de razonamiento backend y el harness del agente se facturan aparte. Léelo otra vez: el minuto barato es solo la boca y los oídos. El cerebro lo pagas aparte.
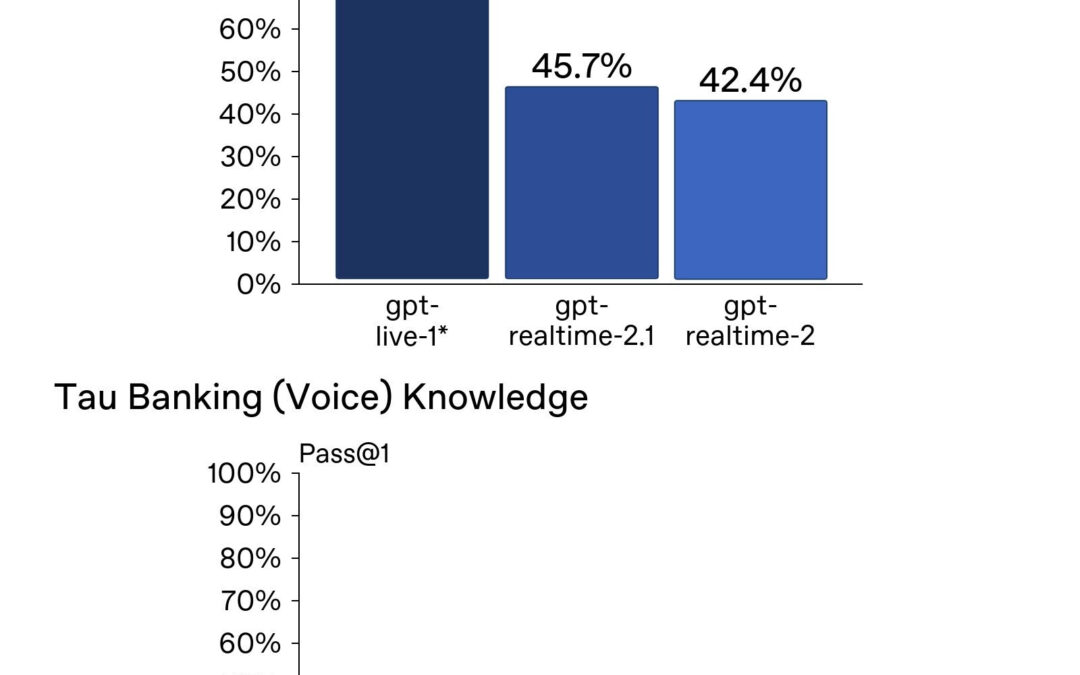
Los números que OpenAI publicó son agresivos. En el benchmark Tau3 —tareas de voz de atención al cliente en aerolíneas, retail y telecom— GPT-Live-1 emparejado con GPT-6 Astra logra 86.2% Pass@1, contra 45.7% de GPT-Realtime-2.1 y 42.4% de GPT-Realtime-2. La latencia de turn-taking baja a 0.8 segundos desde 1.4s, y en Full Duplex Bench sube 30 puntos porcentuales (80.1% vs 45.4%). El tool-calling pasa de 60% a 87%.
Yelp ya lo desplegó en Yelp Host y Hatch para reservas de restaurantes y pedidos de comida. Su CTO Alex Levy reporta mejoras en la tasa de gestión de llamadas y que los clientes hablan frases más completas. La app de idiomas Speak reportó ~80% menos interrupciones. Lanza con 12 voces que cubren acentos, dialectos e idiomas.
Qué significa
El movimiento estratégico de OpenAI es claro: desacoplar la capa de voz del motor de razonamiento. Commoditiza el habla en tiempo real y empuja el valor hacia los orquestadores que combinan GPT-Live-1 con modelos backend. Traducción de operador: si construyes sobre una sola capa, tu margen se erosiona. Si orquestas bien, capturas el valor.
El pipeline en cascada murió. El Realtime API de 2024 armaba STT → LLM → TTS con latencias P50 de 800 ms a 2 segundos, y peores en P99 bajo carga. Ese diseño es el que hacía que tu cliente colgara en el menú de opciones. El full-duplex elimina la fricción de turnos, y ahí está el ahorro real: no en el minuto, sino en la llamada que antes se perdía.
Pero ojo con los benchmarks. Tau3 y Full Duplex Bench son vendor-reported: los publica OpenAI, no un tercero independiente. El caso Yelp es cualitativo —»frases más naturales»— no un número de ahorro verificable. The Register apunta algo incómodo: Yelp no aclara si los clientes reciben con agrado el robo-banter más fluido o simplemente lo aceptan porque es mejor que esperar en línea para hablar con una persona.
Y el precio. The Decoder lo dice sin anestesia: no es barato. $0.05/min es solo la capa de voz. El costo total depende del modelo backend y del volumen de razonamiento profundo. Si tu mix de llamadas es rutinario, GPT-Live-1 con un backend ligero te sale bien. Si cada llamada exige razonamiento pesado con GPT-6 Astra, tu costo por llamada se dispara y el titular de los cinco centavos se vuelve marketing.
Qué hacer al respecto
Si esto toca tu operación, muévete en este orden:
- Recalcula tu costo por llamada hoy. Suma los $0.05/min de voz + backend + harness. Modela el mix real: qué porcentaje de tus llamadas son rutinarias (backend ligero) vs. complejas (GPT-6 Astra). Ese número decide si el proyecto vive o muere.
- Corre un A/B con tus propias llamadas. No confíes en Tau3 ni en el caso Yelp. Toma 200 llamadas reales, pásalas por GPT-Live-1 y por tu IVR actual, y mide tasa de contención, duración y escalado a humano. Sin eso, estás comprando humo con benchmark ajeno.
- Rediseña prompts y flujos de escalado. El full-duplex cambia el juego: el cliente interrumpe, se corrige, cambia de tema. Tus prompts de turn-based no aguantan eso. Define cuándo el agente pasa a humano y cómo, antes de soltarlo en producción.
- Compara contra el mercado completo. Vapi cobra $0.05/min más costos de modelo; ElevenLabs $0.08/min; Retell AI entre $0.07 y $0.31/min según configuración. GPT-Live-1 es competitivo en precio, pero su ventaja real está en latencia (0.8s) y tool-calling (87%). Compra por eso, no por el minuto.
- Prepara gobernanza de voz. 12 voces estándar, voces custom solo vía ventas, y OpenAI añadió watermarking SynthID al audio generado desde julio de 2026. Si operas en banca, seguros o salud, esto es cumplimiento y detección de fraude, no un detalle técnico.
La pregunta no es si migras a voz full-duplex. Es si lo haces con números propios o con el folleto del vendedor. La segunda opción ya sabemos cómo termina.
¿Ya corriste números de GPT-Live-1 API voz tiempo real en tu operación? Cuéntame en comentarios qué te salió el costo real por llamada. Si te dio más barato que tu IVR, quiero ver el desglose. Si te dio más caro, también.
Preguntas frecuentes
¿Cuánto cuesta realmente GPT-Live-1 API por llamada?
El precio de portada es $0.05 por minuto, pero eso cubre solo la capa de voz. Debes sumar el modelo backend de razonamiento (GPT-6 Astra u otro) y el harness del agente, que se facturan aparte. El costo real depende de cuánto razonamiento profundo exija cada llamada.
¿GPT-Live-1 reemplaza mi IVR completo?
Técnicamente puede manejar la conversación completa, pero el reemplazo no es automático. Necesitas rediseñar prompts, definir flujos de escalado a humano y correr pruebas A/B con tus propias llamadas antes de apagar el IVR.
¿Es más barato que Vapi, ElevenLabs o Retell AI?
En la capa de voz, GPT-Live-1 ($0.05/min) empata con Vapi y sale más barato que ElevenLabs ($0.08/min) y el rango alto de Retell ($0.31/min). Pero el costo total depende del backend. La ventaja real de GPT-Live-1 está en latencia de 0.8s y tool-calling de 87%.
¿Los benchmarks de GPT-Live-1 son confiables?
Los números de Tau3 y Full Duplex Bench los reporta OpenAI, no un tercero independiente. El caso Yelp es cualitativo, no un ahorro medido. Trátalos como referencia de vendedor y valida con tus propios datos.
Fuentes
- OpenAI — Build more natural voice experiences with GPT-Live-1 in the API
- The Register — OpenAI arms devs with AI conversation tool
- The Decoder — GPT-Live-1 API lets developers build apps that talk and listen
- Unite.AI — GPT-Live-1 Arrives in the API at $0.05 Per Minute
- TechTimes — Full-Duplex Voice AI Hits Developer APIs