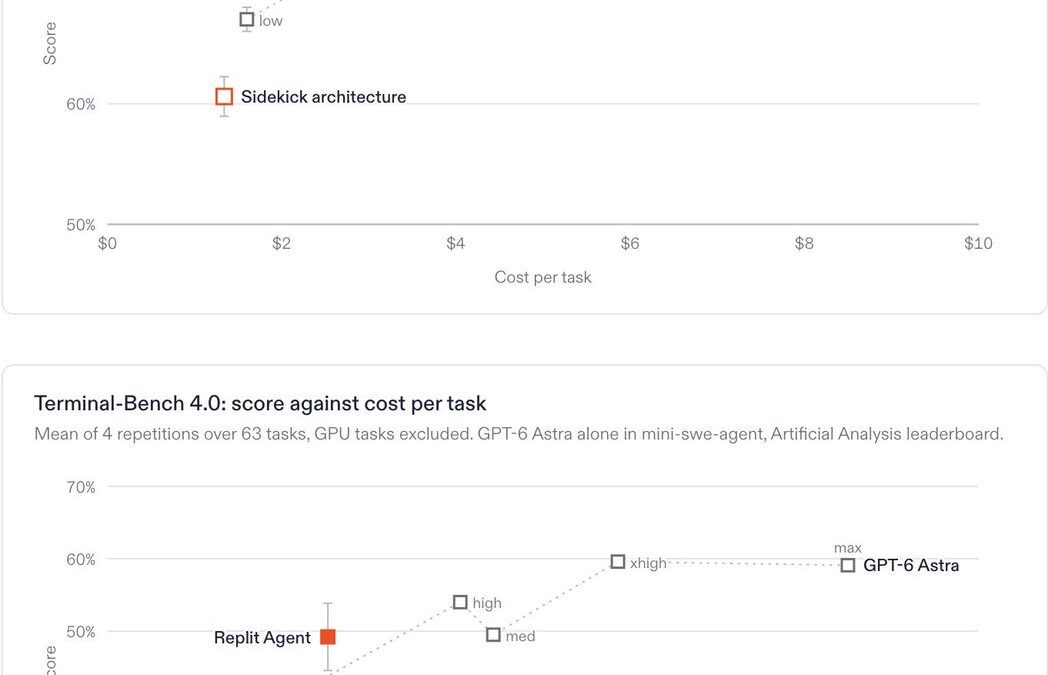
Replit dice que ya no trabaja con Anthropic, y el argumento entero cabe en dos números: 2,11 contra 2,53 dólares por tarea. No es una pelea de egos ni una guerra cultural de modelos. Es aritmética de márgenes.
El CEO Amjad Masad lo soltó en vivo en el TechCrunch Disrupt del 16 de octubre de 2026: OpenAI es ahora su proveedor por «costo, partnership y desempeño». La afirmación está disputada, y eso importa. Pero lo verdaderamente jugoso no es si la relación murió: es que un cliente grande acaba de mostrar, con benchmark en mano, cómo se decide hoy un proveedor de IA. Spoiler: no se decide por lealtad.
Qué pasó
Masad dijo en el escenario que Replit ya no trabaja con Anthropic y que OpenAI quedó como proveedor principal. La munición viene de su propio post de ingeniería del 29 de septiembre, donde Replit Agent en Max Mode con GPT-6 Astra como loop principal logra 72% en DeepSWE v1.1 (113 tareas de programación) a 2,11 USD por tarea, y 49% en Terminal-Bench 4.0 a 2,53 USD por tarea.
El mismo setup supera por 11 puntos en DeepSWE y 16 en Terminal-Bench a la arquitectura «sidekick» de un solo worker de larga vida. Y cuando fuerzan a Astra solo a esfuerzo de razonamiento máximo, el score sube a 74% y 60%… pero el costo por tarea se dispara a 4,43 y 5,86 USD. Dos puntos más de calidad por más del doble de plata. Ahí está el negocio completo en una tabla.
El partnership con OpenAI se había anunciado el 18 de agosto de 2026 con Free Mode sobre GPT-5.6 Luna, con la promesa de que los suscriptores Core podrían crear hasta 30 veces más por sus 20 USD/mes. Replit aparece con valoración de 9.000 millones y un run rate cercano a 1.000 millones para 2026.
Qué significa
Primero, la letra chica. Una fuente cercana a la relación dijo a TechCrunch que el vínculo con Anthropic seguía activo, los registros de producción muestran Claude Fable 5.1 corriendo en septiembre y la documentación del selector de modelos todavía lista Opus 5.5, Sonnet 5, Opus 5, Opus 4.8 y Sonnet 4.6 junto a Astra, Luna Fast y Kimi K3. Un empleado de producto incluso escribió en X que usaba Opus 5.5. Masad dijo «for now» y no dio cifras en el escenario.
Segundo, la comparación no es simétrica. El benchmark publicado solo rankea configuraciones construidas sobre Astra. Los modelos de Anthropic no aparecen en la tabla de calidad, solo en datos de comportamiento de subagentes: Fable 5 delega en 32% de los turnos, Fable 5.1 en 21%, Astra en 36%. Los handoffs a un worker genérico pasan de 0,9% a 20%. Es decir: la tabla que sostiene el anuncio mide una arquitectura, no un modelo contra otro. Eso no la invalida, pero sí la vuelve un argumento de ingeniería, no de marketing.
Tercero, y esto es lo que te debería quitar el sueño: Replit deja Anthropic por OpenAI en un contexto donde el costo marginal de una plataforma de vibe coding es casi todo inferencia. Cada décima de dólar por tarea se multiplica por millones de sesiones gratuitas. Cuando tu producto regala cómputo para captar usuarios, el precio del token no es un detalle de procurement: es tu EBITDA.
Y cuarto, el timing. GPT-6 Sol y Luna salieron a fines de septiembre con API a mitad de precio, y OpenAI superó a Anthropic en OpenRouter por primera vez. La guerra de precios convirtió al proveedor de modelos en una decisión de márgenes revisable cada trimestre. Cursor y Windsurf ya lo venían haciendo: rotan modelos según benchmark y costo por tarea. Replit solo lo dijo en voz alta.
Qué hacer al respecto
1. Mide costo por tarea completada, no precio por token. El dato que importa es 2,11 USD por tarea al 72% de éxito. Un modelo más barato por token puede salir más caro si te obliga a reintentar. Arma tu propia métrica: costo total de la sesión dividido entre tareas que el usuario aceptó sin tocar.
2. Construye una capa de abstracción de modelos antes de firmar cualquier contrato. Router propio, prompts portables, evals que corran contra dos o tres proveedores. La pregunta no es si vas a cambiar de modelo, es cuántas semanas te va a tomar. Si la respuesta es «un trimestre», ya perdiste.
3. No tomes el anuncio del CEO como verdad operativa. Este caso es la prueba perfecta: el escenario dijo una cosa, la telemetría de producción y la documentación dicen otra. Verifica con tus evals y con tus logs antes de reescribir arquitectura o contratos.
4. Negocia con dos proveedores en paralelo y deja tráfico residual en el segundo. El ahorro de casarte con uno solo se paga en riesgo de discontinuidad y en poder de negociación. Un 5% de tráfico al modelo B te cuesta poco y te mantiene vivo el plan B.
5. Presupuesta el razonamiento máximo como excepción, no como default. Pasar de esfuerzo medio a xhigh duplicó el costo por tarea (2,11 a 4,43 USD) por dos puntos de score. Define umbrales de escalado por tipo de tarea y mide cuántas veces tu agente se pasa de listo sin necesidad.
El punto ciego de la lealtad
Hay una lectura cómoda de esta historia: «Replit cambió de proveedor, qué traidor». Es la lectura equivocada. La pregunta correcta es cuántas empresas están hoy pagando 40% más por tarea simplemente porque nadie se sentó a medirlo.
El costo por tarea es el nuevo costo por adquisición. Si no lo tienes en un dashboard, estás operando a ciegas con la plata de tus inversionistas o de tus clientes. Y ojo: la asimetría del benchmark de Replit es exactamente el tipo de trampa en la que caes cuando dejas que el proveedor te arme la comparación.
¿Tú sabes cuánto te cuesta una tarea completada en tu producto hoy, con reintentos incluidos? Si la respuesta es «más o menos», escríbeme y lo calculamos. Y si ya migraste de proveedor, cuéntame en comentarios qué te salió más caro: el cambio o la factura anterior.
Preguntas frecuentes
¿Replit dejó de trabajar con Anthropic de verdad? El CEO Amjad Masad lo afirmó en el TechCrunch Disrupt del 16 de octubre de 2026, pero una fuente cercana dijo a TechCrunch que la relación seguía activa y los registros de producción muestran Claude Fable 5.1 corriendo en septiembre. La versión pública y la operativa no coinciden.
¿Cuánto cuesta una tarea en Replit Agent con GPT-6 Astra? Según el blog de ingeniería de Replit del 29 de septiembre de 2026, 2,11 USD por tarea en DeepSWE v1.1 con 72% de éxito, y 2,53 USD por tarea en Terminal-Bench 4.0 con 49%. Forzando razonamiento máximo, sube a 4,43 y 5,86 USD.
¿Por qué el costo por tarea importa más que el precio por token? Porque un modelo barato por token que falla más te obliga a reintentar y a gastar turnos extra. Lo que pega en tu margen es el costo total de completar la tarea, no el precio de lista de un millón de tokens.
¿Cómo evito depender de un solo proveedor de IA? Con una capa de abstracción propia: router de modelos, prompts portables, evals que corran contra varios proveedores y un segundo modelo con tráfico residual en producción. Así el cambio se mide en semanas, no en trimestres.
Fuentes
- Replit CEO Masad Says Company No Longer Works With Anthropic – Unite.AI
- Replit CEO says Anthropic relationship has ended, but that claim is disputed – Superpower Daily (vía TechCrunch)
- Replit Announces Split From Anthropic, but the Breakup Is Disputed – Pasquale Pillitteri
- Replit Drops Anthropic? Claimed vs Verified (Oct 2026) – explainx.ai
- Closing the loop: Evaluating and improving Replit – Replit Blog